7 Leggere i dati
Una tabella si riassume con pochi numeri e pochi grafici; saperli leggere è più difficile che calcolarli.
- frequenze
- istogramma
- media e mediana
- quartili
- boxplot
- deviazione standard
- skewness
- curtosi
- correlazione
- ggplot2
Lezione
Il catalogo
Il file business_intelligence.csv descrive 80 prodotti di un’azienda in cinque categorie (Abbigliamento, Alimentari, Casa, Elettronica, Sport): prezzo, unità vendute, fatturato, valutazione dei clienti, numero di recensioni, tasso di reso, margine, giorni di giacenza in magazzino, costo di magazzino e ritardo del fornitore. Una riga per prodotto.
Il percorso è quello di qualunque analisi: una variabile alla volta (com’è fatta, quanto varia, che forma ha), poi gruppi a confronto, poi due variabili insieme. Quasi tutto il modulo lavora sul fatturato per prodotto; la curtosi, che ha bisogno di esempi più estremi, usa anche due file in più.
library(dplyr)
library(ggplot2)

vendite <- read.csv("business_intelligence.csv")
summary(vendite)
Dalla tabella all’istogramma
Il primo riassunto di una colonna numerica è una tabella di frequenza: si divide il fatturato in fasce e si conta quanti prodotti cadono in ognuna. La frequenza relativa è \(f_i = n_i / N\), la quota di prodotti nella fascia.
vendite %>%
  mutate(fascia = cut(fatturato, breaks = c(0, 50000, 100000, 150000, 200000, Inf))) %>%
  count(fascia) %>%
  mutate(freq_rel = n / sum(n))
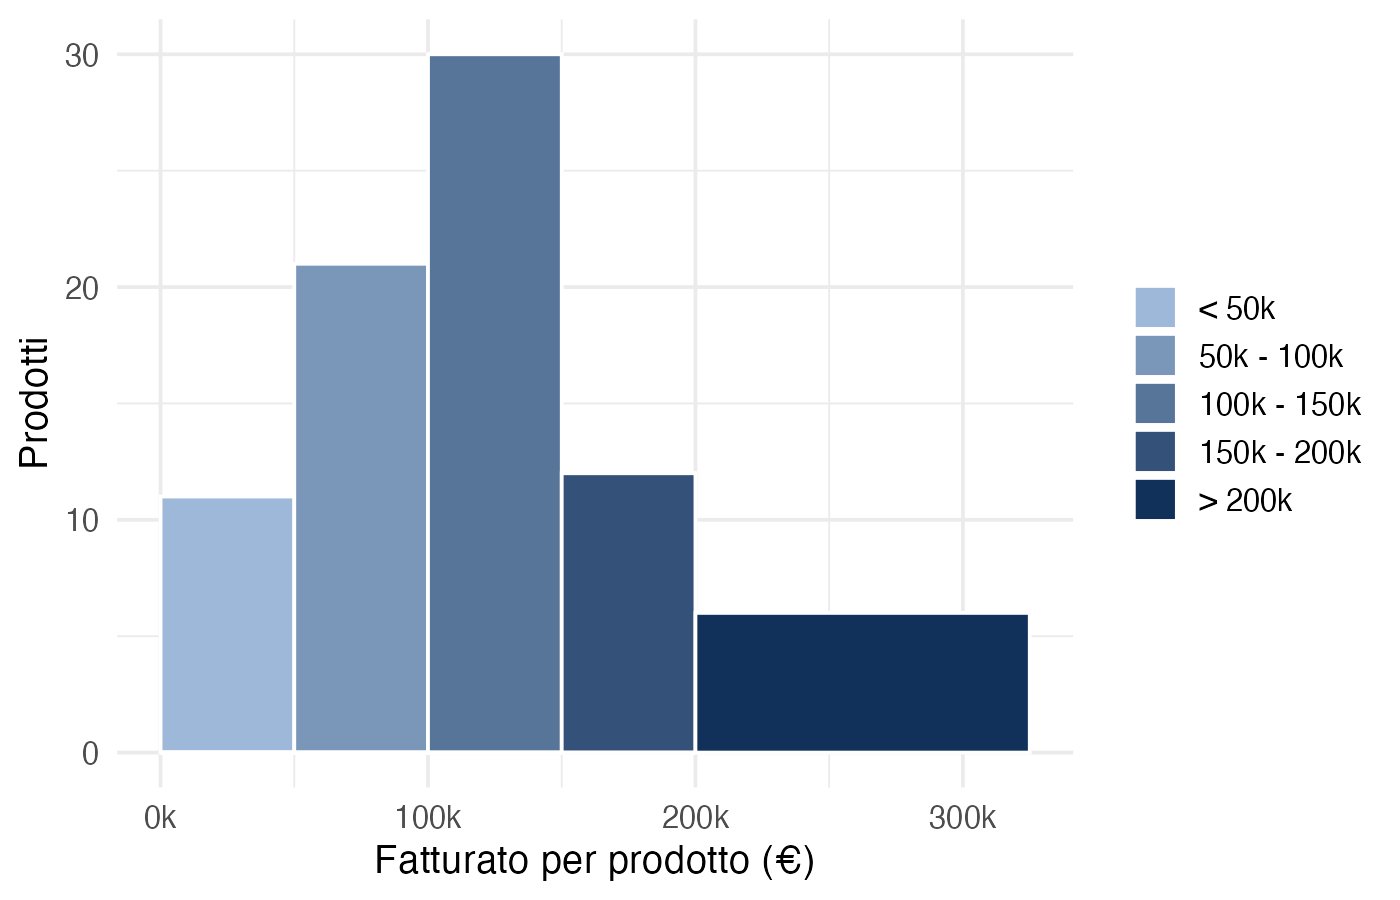
Il grafico è la tabella disegnata: ogni barra è una fascia, e la sua altezza è il numero di prodotti (11, 21, 30, 12, 6). Si legge subito che la fascia più affollata è 100k–150k, con 30 prodotti su 80 (37,5 %), e che sopra i 200k ce ne sono solo 6.
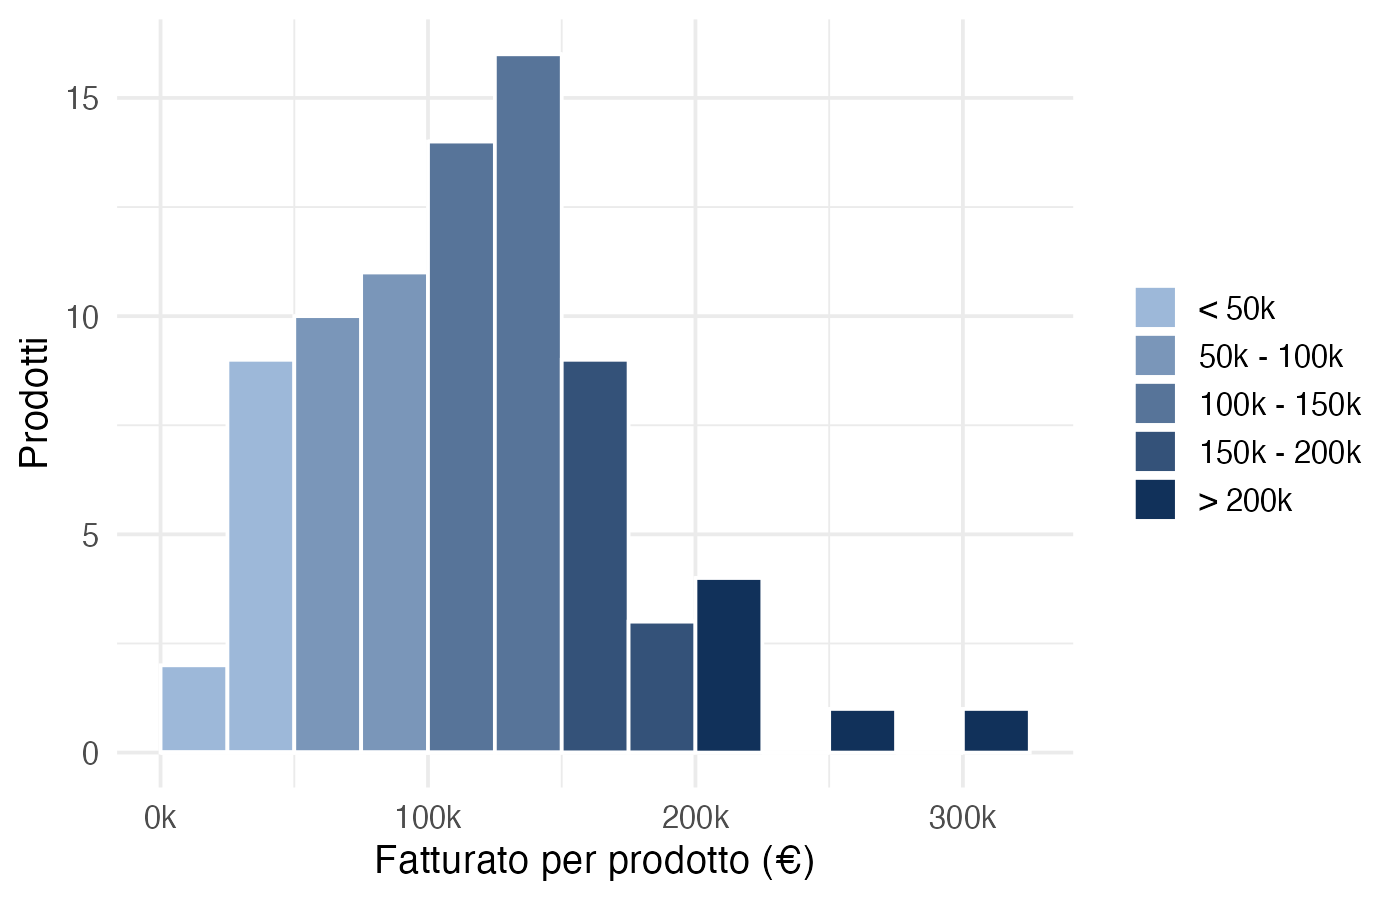
Con barre più fini, da 25k invece che da 50k, si vede meglio la forma. I colori sono gli stessi delle fasce: ogni barra larga si è divisa in due barre fini. La forma generale non cambia, ma compaiono dettagli che la tabella nascondeva, come i due prodotti isolati oltre i 250k.
Prodotto per prodotto
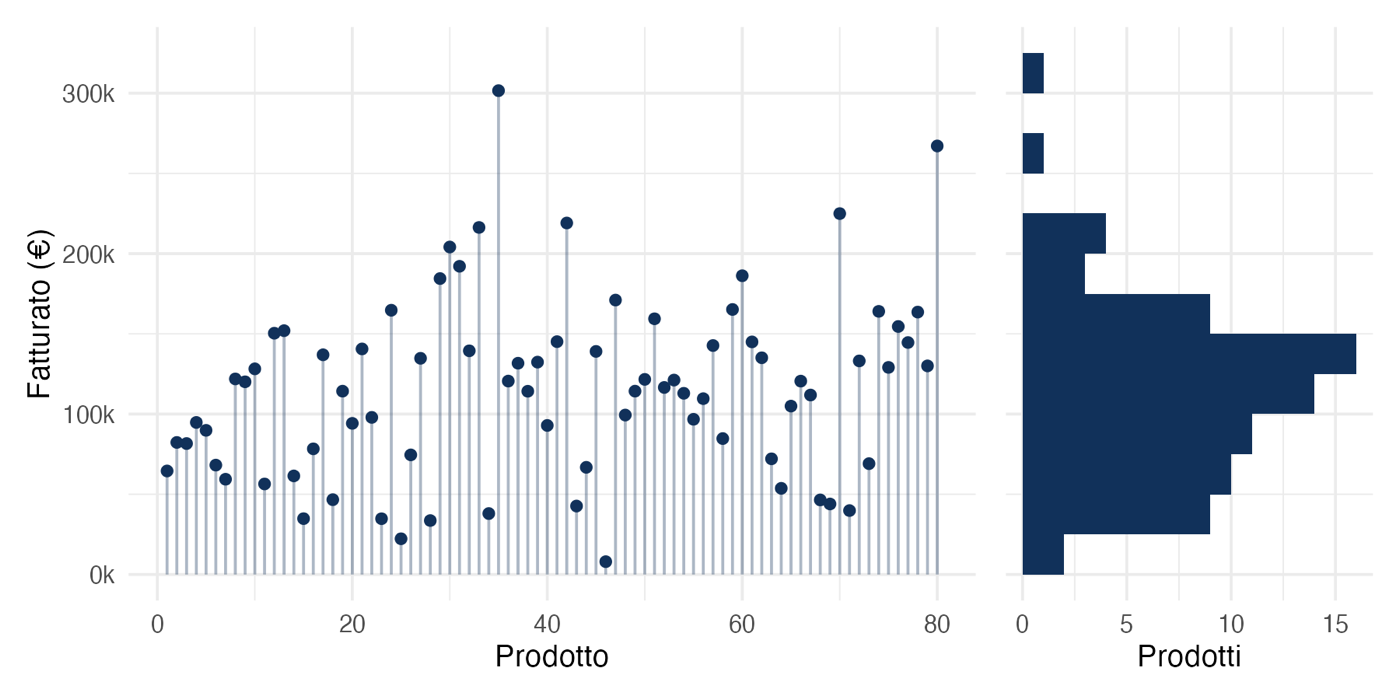
A sinistra ogni punto è un prodotto, nell’ordine del catalogo; a destra lo stesso fatturato come istogramma, girato in orizzontale e sulla stessa scala. Se si facessero cadere tutti i punti di sinistra sull’asse verticale e si contassero, si otterrebbe proprio l’istogramma di destra. Il grafico di sinistra dice quale prodotto fattura quanto; quello di destra dice quanti prodotti fatturano quanto.
Cinque numeri sul grafico
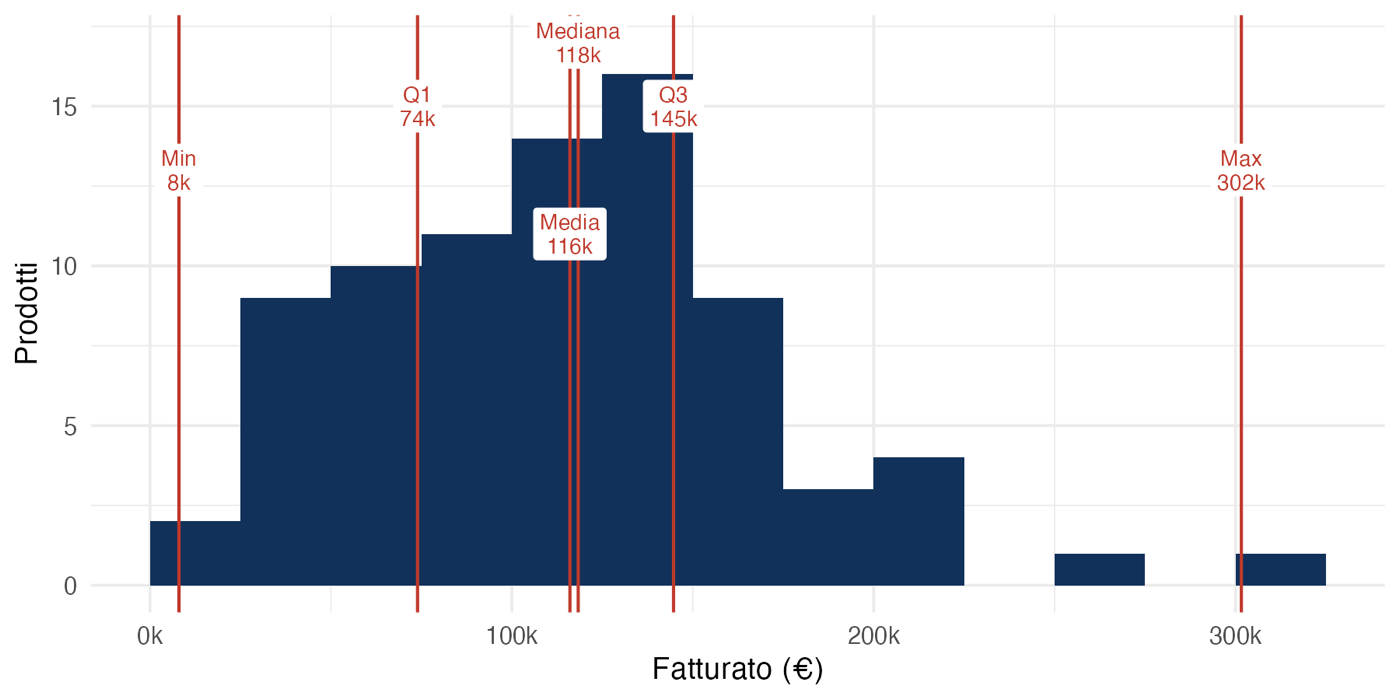
Sei valori riassumono la distribuzione:
| Min | Q1 | Mediana | Media | Q3 | Max |
|---|---|---|---|---|---|
| 8.004 | 73.949 | 118.351 | 116.047 | 144.688 | 301.599 |
- La media è \(\bar{x} = \frac{1}{N}\sum_{i=1}^{N} x_i\).
- La mediana è il valore che sta a metà una volta ordinati i prodotti: 40 fatturano meno di 118.351 €, 40 di più.
- I quartili dividono i prodotti in quattro gruppi di 20. R li calcola con
quantile(): il quantile \(Q_p\) è il valore in posizione \(1 + (N-1)\,p\) nei dati ordinati.
Qui media e mediana sono quasi uguali, segno di una distribuzione abbastanza simmetrica; la scatola centrale tra Q1 e Q3 contiene metà dei prodotti.
Il boxplot
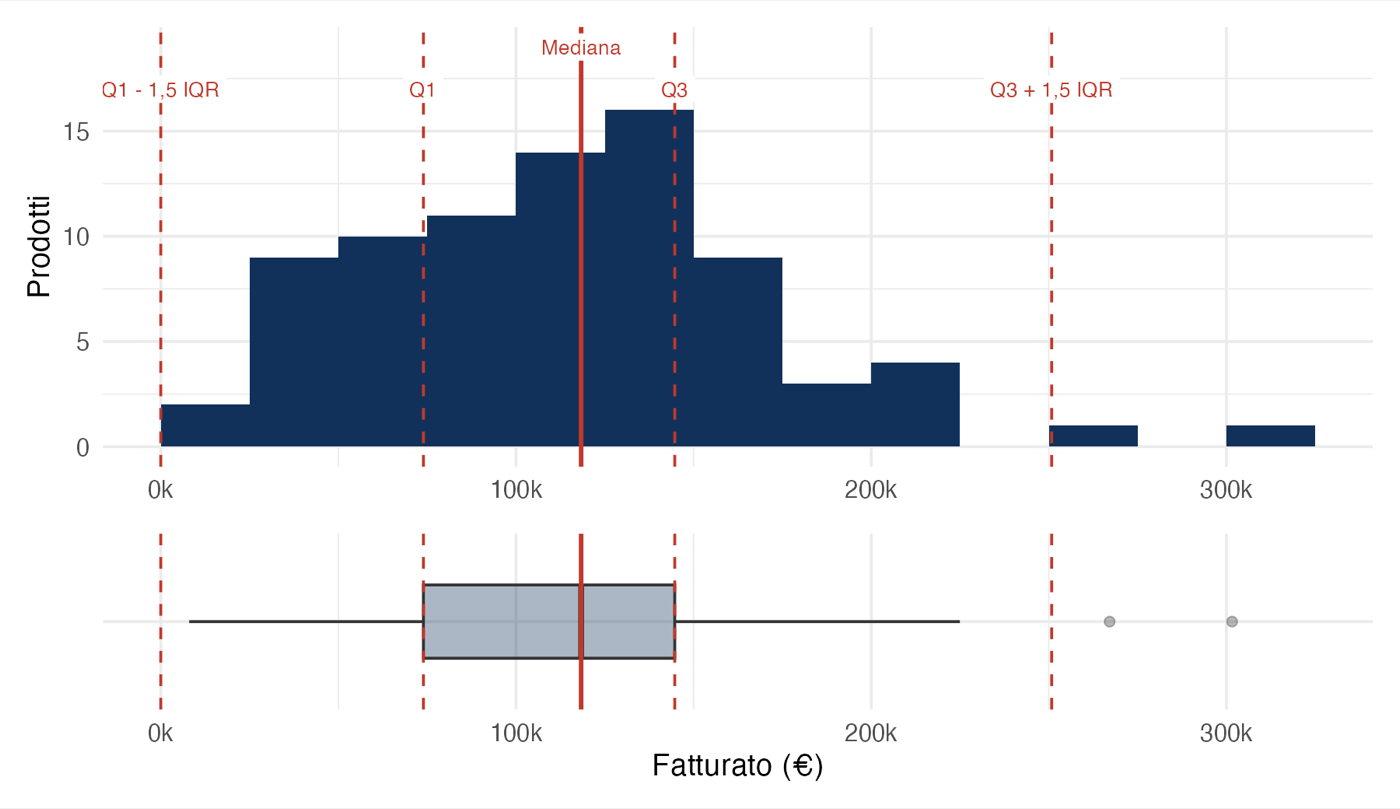
Il boxplot è l’istogramma visto dall’alto. La scatola va da Q1 a Q3, la riga dentro è la mediana. La larghezza della scatola è lo scarto interquartile \(IQR = Q_3 - Q_1 = 70.739\). I baffi arrivano fino all’ultimo prodotto entro \(Q_1 - 1{,}5 \cdot IQR\) e \(Q_3 + 1{,}5 \cdot IQR = 250.796\): in basso il limite è negativo, quindi il baffo si ferma al minimo; in alto i due prodotti oltre 250.796 € compaiono come punti isolati.
ggplot(vendite, aes(x = fatturato)) +
  geom_boxplot()
Variabilità
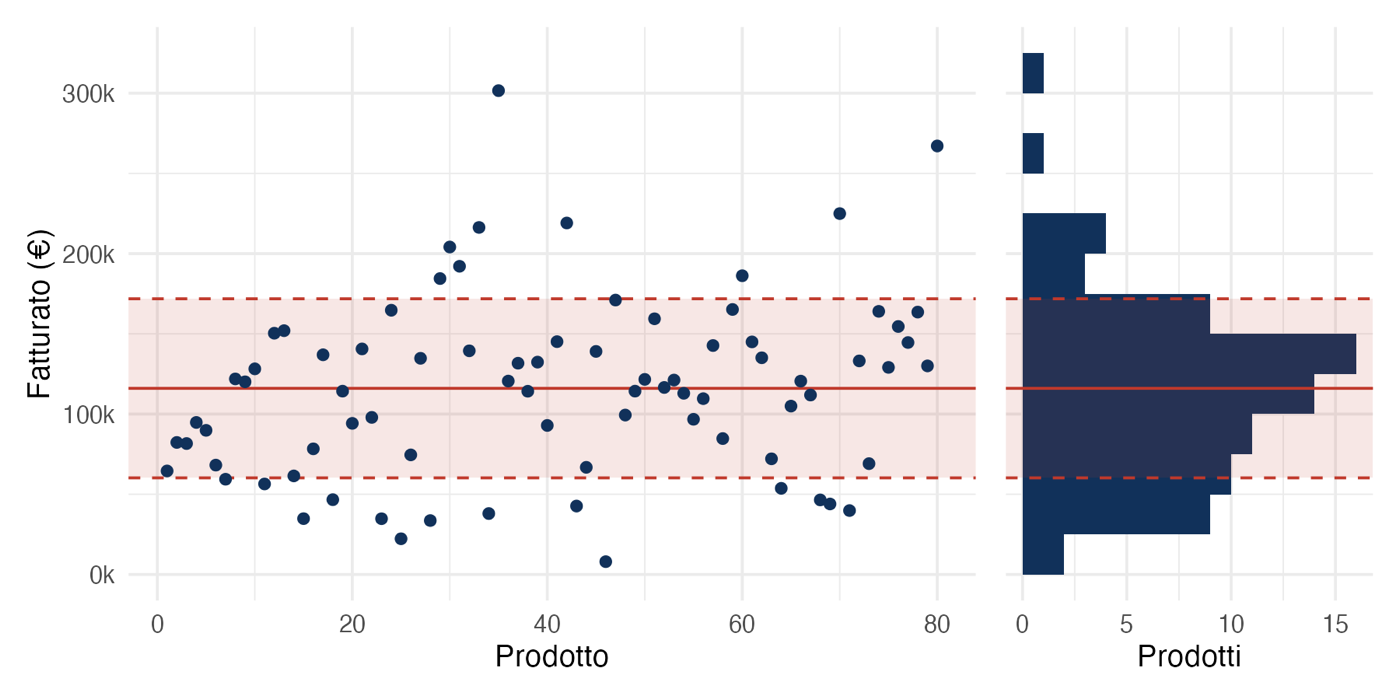
La deviazione standard misura quanto i valori si allontanano dalla media:
\[s = \sqrt{\frac{\sum_{i=1}^{N} (x_i - \bar{x})^2}{N-1}}\]È quello che calcola sd(): per il fatturato 55.817 €. Nel grafico la linea piena è la media, la banda è media ± una deviazione standard: ci cadono 57 prodotti su 80, e entro due deviazioni standard 78. Più la banda è larga, più i prodotti sono diversi tra loro.
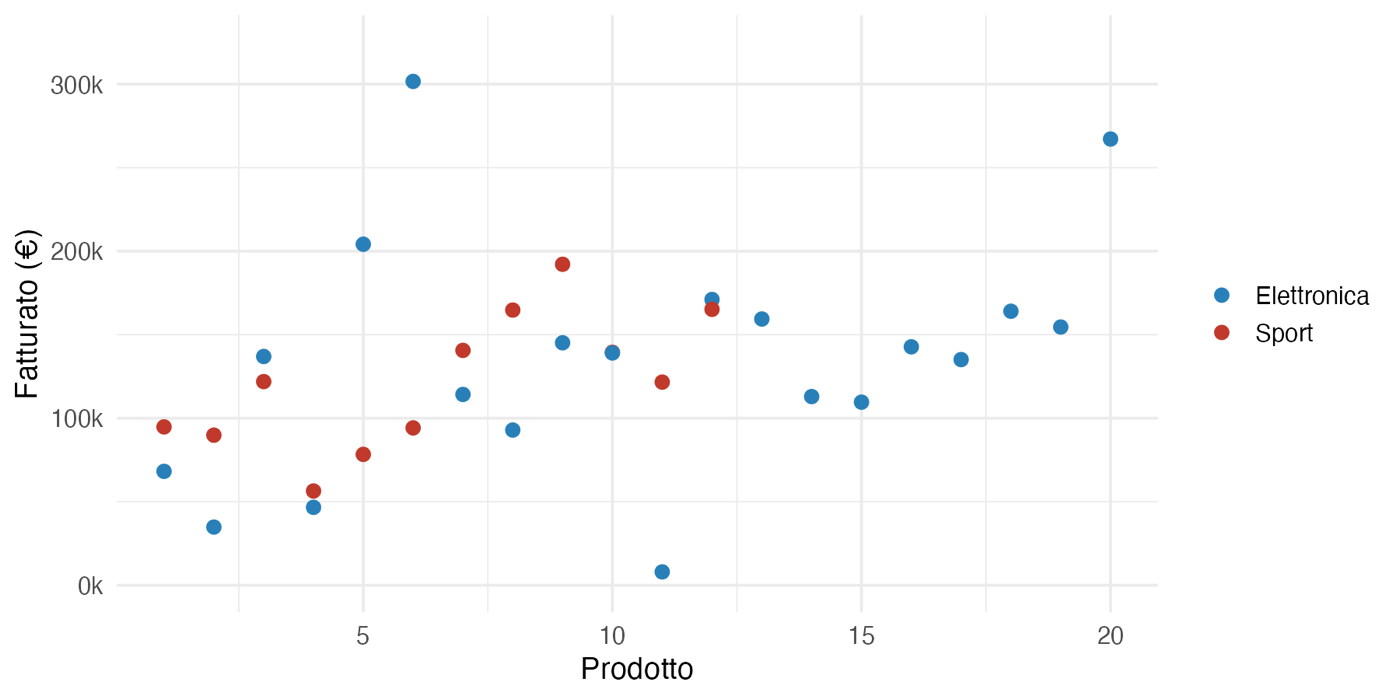
Elettronica e Sport hanno medie vicine (135.410 e 121.602 €), ma i punti blu sono sparsi da 8.004 a 301.599 €, quelli rossi stanno tutti tra 56.444 e 192.116 €.
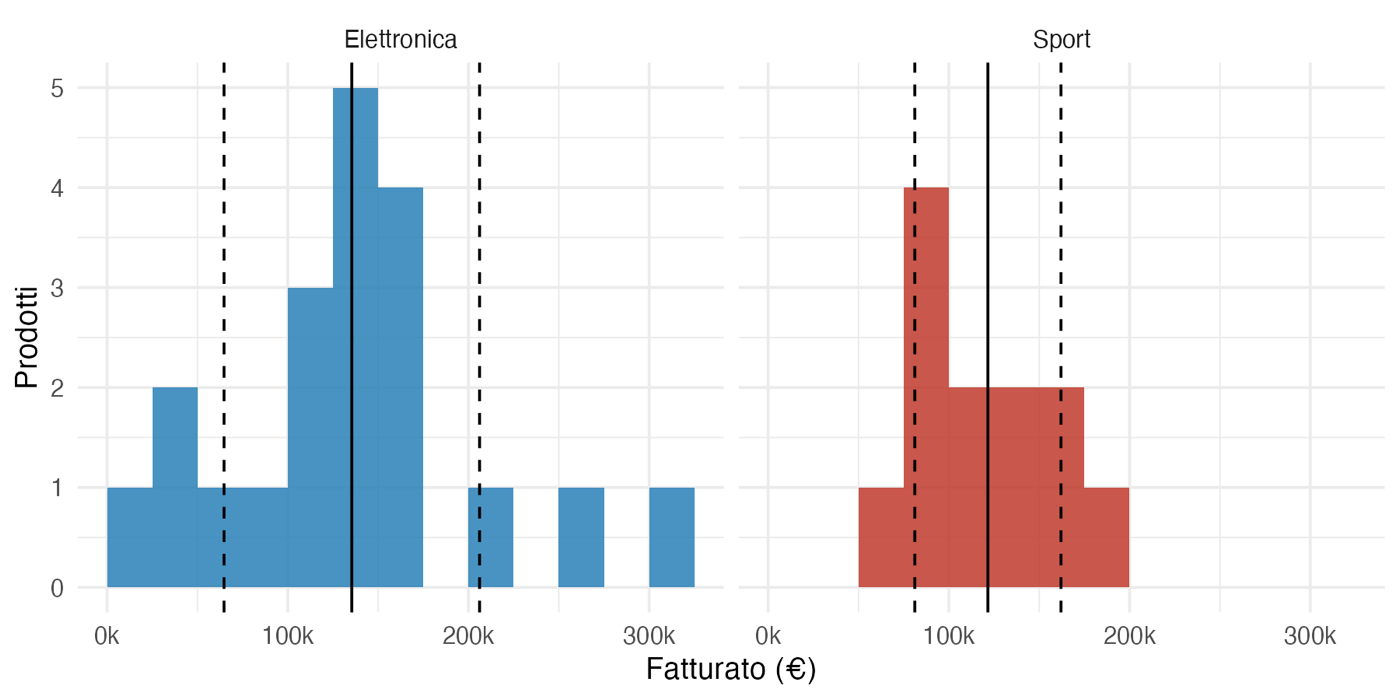
Gli stessi dati come istogrammi sulla stessa scala, con media (linea piena) e media ± deviazione standard (tratteggiate). La deviazione standard è 70.730 € per l’elettronica e 40.457 € per lo sport: dire che «in media un prodotto di elettronica fattura 135.000 €» è molto meno informativo che dirlo dello sport. In finanza la stessa misura si chiama rischio.
Confronto tra categorie
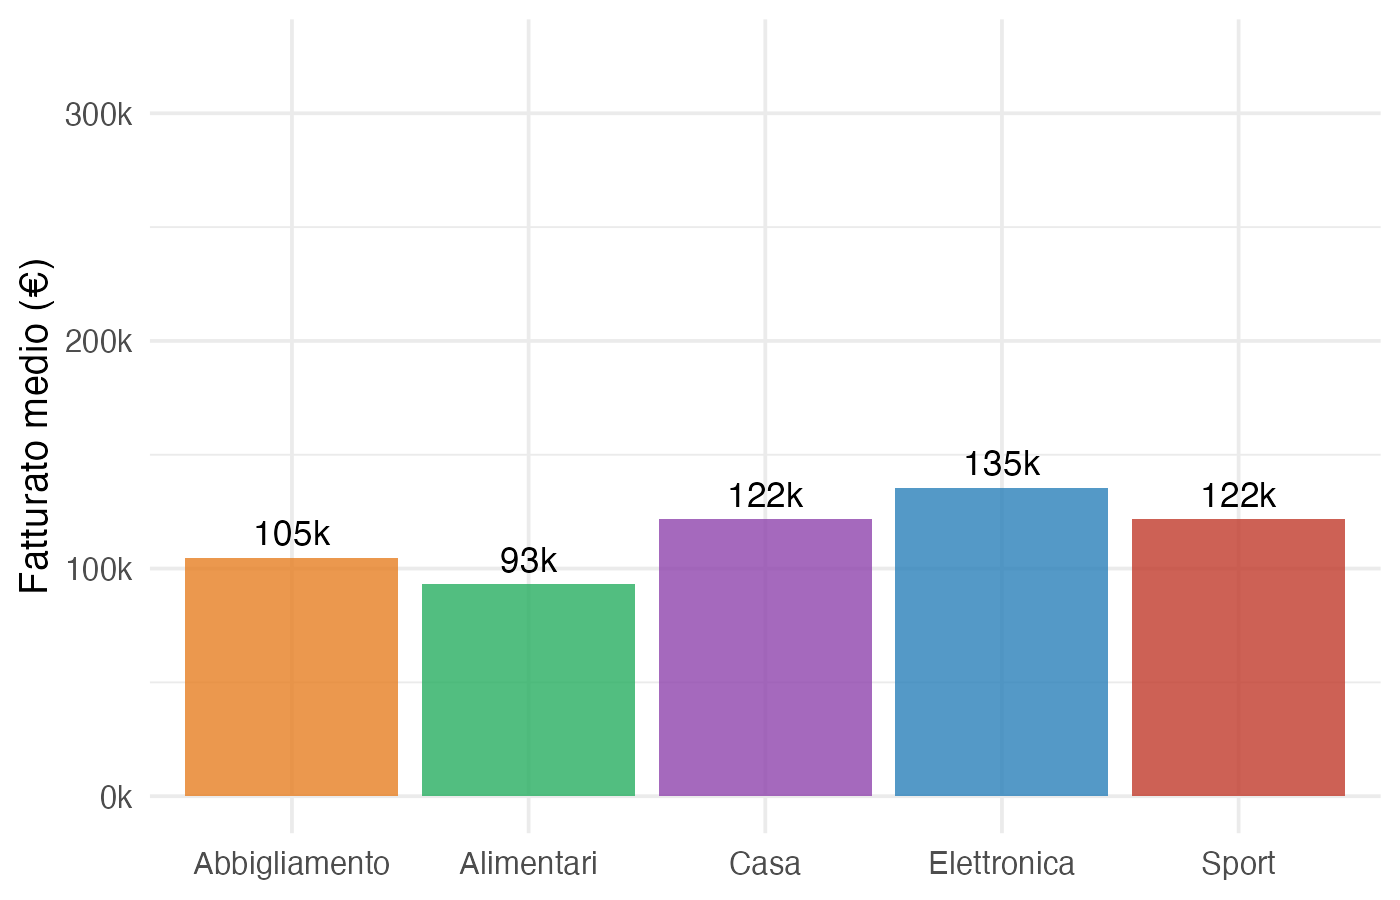
Il grafico a colonne con il fatturato medio dice chi vende di più in media: Elettronica, poi Casa e Sport quasi pari, poi Abbigliamento e Alimentari. Ma una colonna è un numero solo, e nasconde tutto il resto.
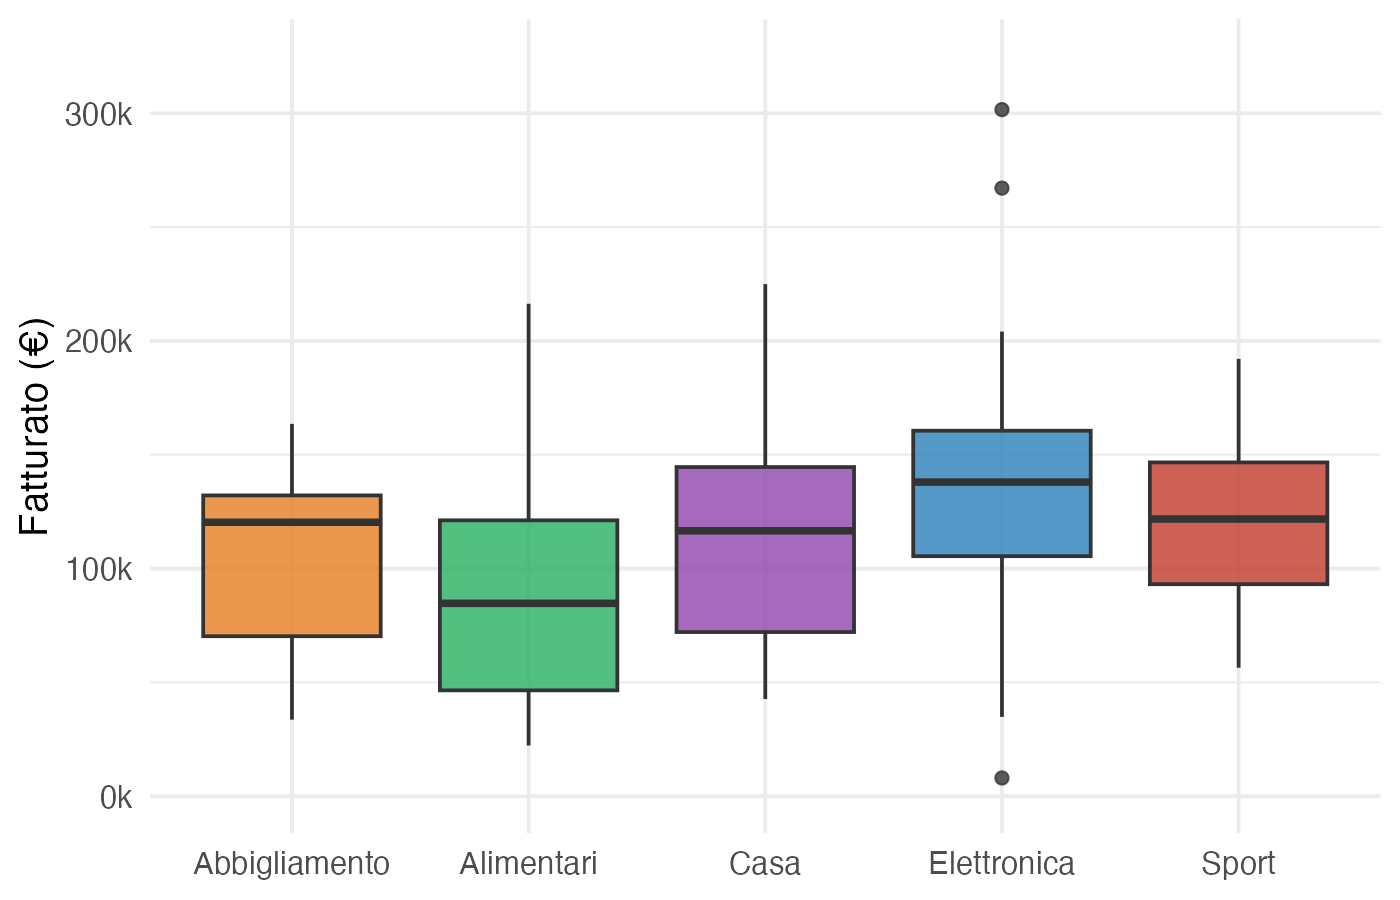
I boxplot, sulla stessa scala, mostrano molto di più:
- l’Abbigliamento ha la mediana (120.337 €) sopra quella di Casa, anche se la sua media è più bassa: pochi prodotti che vendono poco tirano giù la media;
- gli Alimentari hanno la scatola più bassa e più larga;
- l’Elettronica ha la mediana più alta ma anche i tre prodotti anomali, due in alto e uno quasi a zero;
- lo Sport ha la scatola più stretta: prodotti simili tra loro.
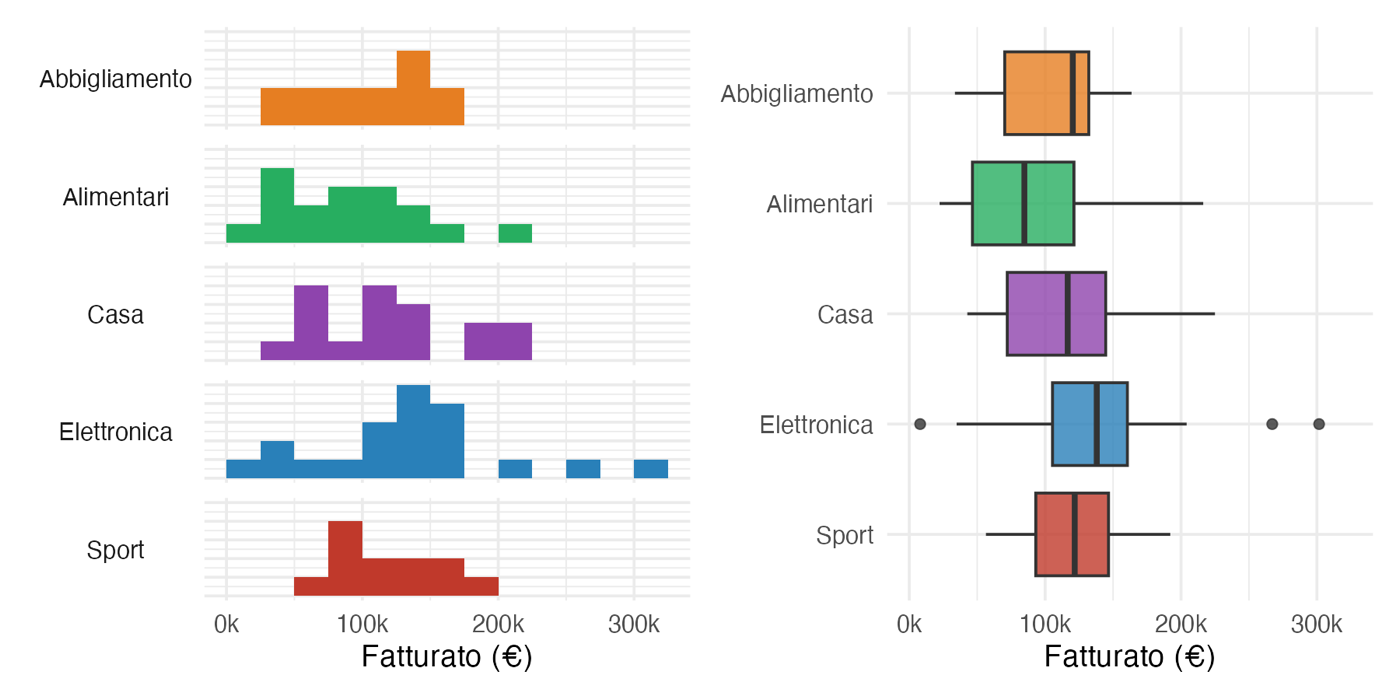
Lo stesso confronto con due grafici affiancati: a sinistra un istogramma per categoria, a destra il boxplot corrispondente, sulla stessa scala. Ogni boxplot è il riassunto dell’istogramma sulla sua riga.
ggplot(vendite, aes(x = categoria, y = fatturato)) +
  geom_boxplot()
Forma: la skewness
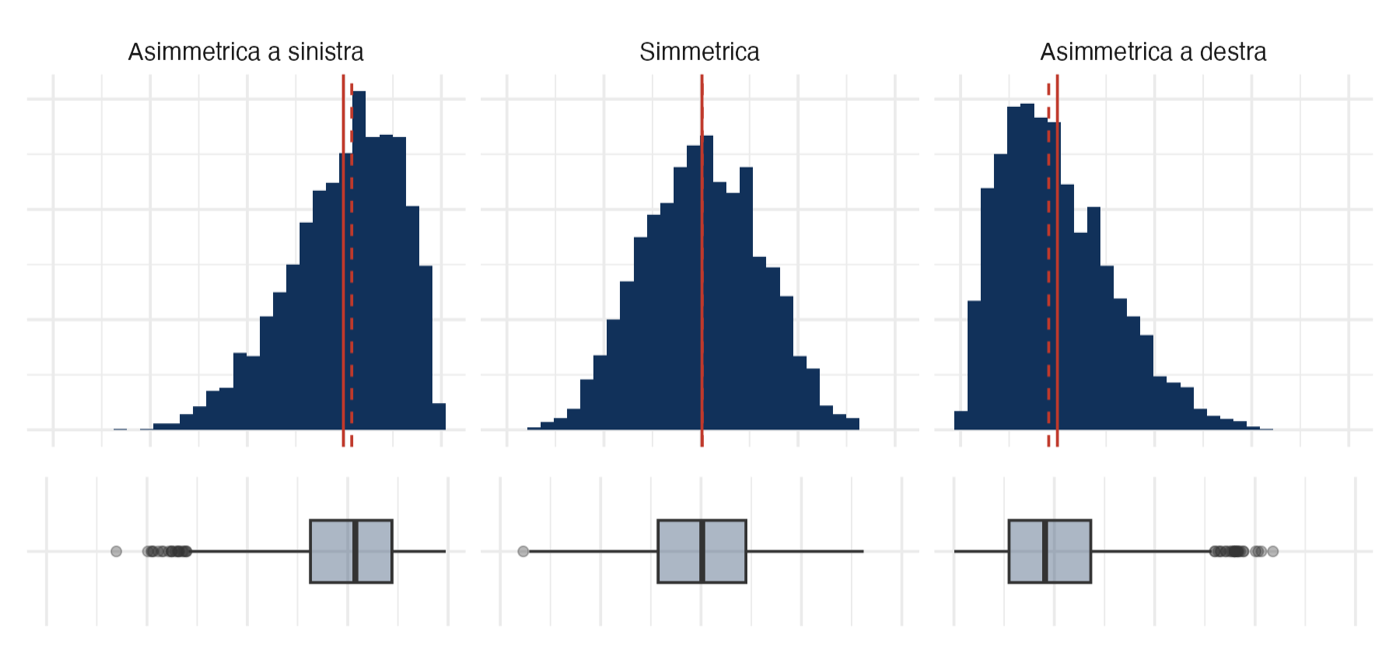
La skewness dice se la distribuzione è simmetrica o ha una coda lunga da un lato:
\[SK = \frac{N}{(N-1)(N-2)} \sum_{i=1}^{N} \left(\frac{x_i - \bar{x}}{s}\right)^3\]Con la coda a destra (SK > 0) pochi valori molto grandi tirano la media sopra la mediana; con la coda a sinistra (SK < 0) succede il contrario. Nel grafico la linea piena è la media, la tratteggiata la mediana: guardare quale delle due sta più a destra è il modo più rapido di leggere la skewness.
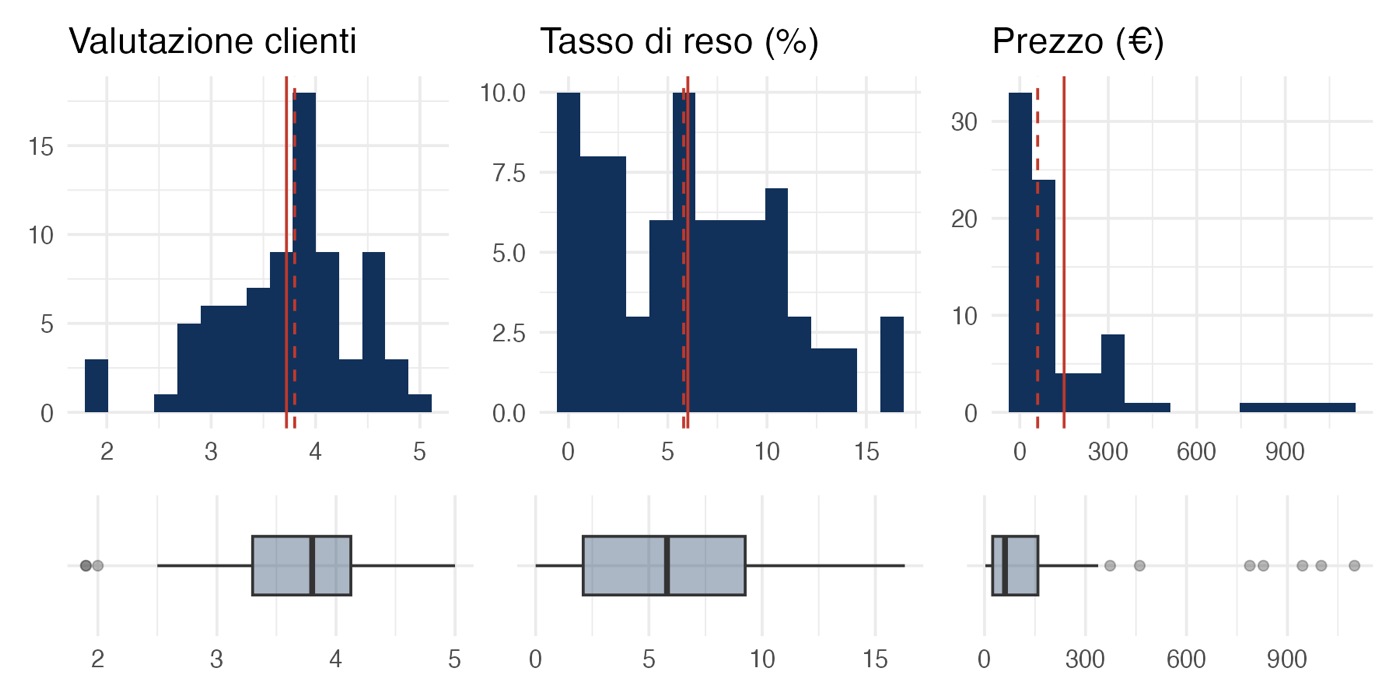
| Media | Mediana | Skewness | |
|---|---|---|---|
| Valutazione clienti | 3,72 | 3,80 | −0,61 |
| Tasso di reso | 6,01 | 5,80 | 0,37 |
| Prezzo | 150,52 | 60,69 | 2,68 |
La valutazione ha la coda a sinistra: quasi tutti i prodotti piacciono, pochi sono bocciati. Il prezzo ha una coda lunghissima a destra: metà dei prodotti costa meno di 61 €, ma la media è 150 € per colpa di pochi prodotti di elettronica molto cari. Per un «prezzo tipico» qui la mediana è la risposta giusta, la media no.
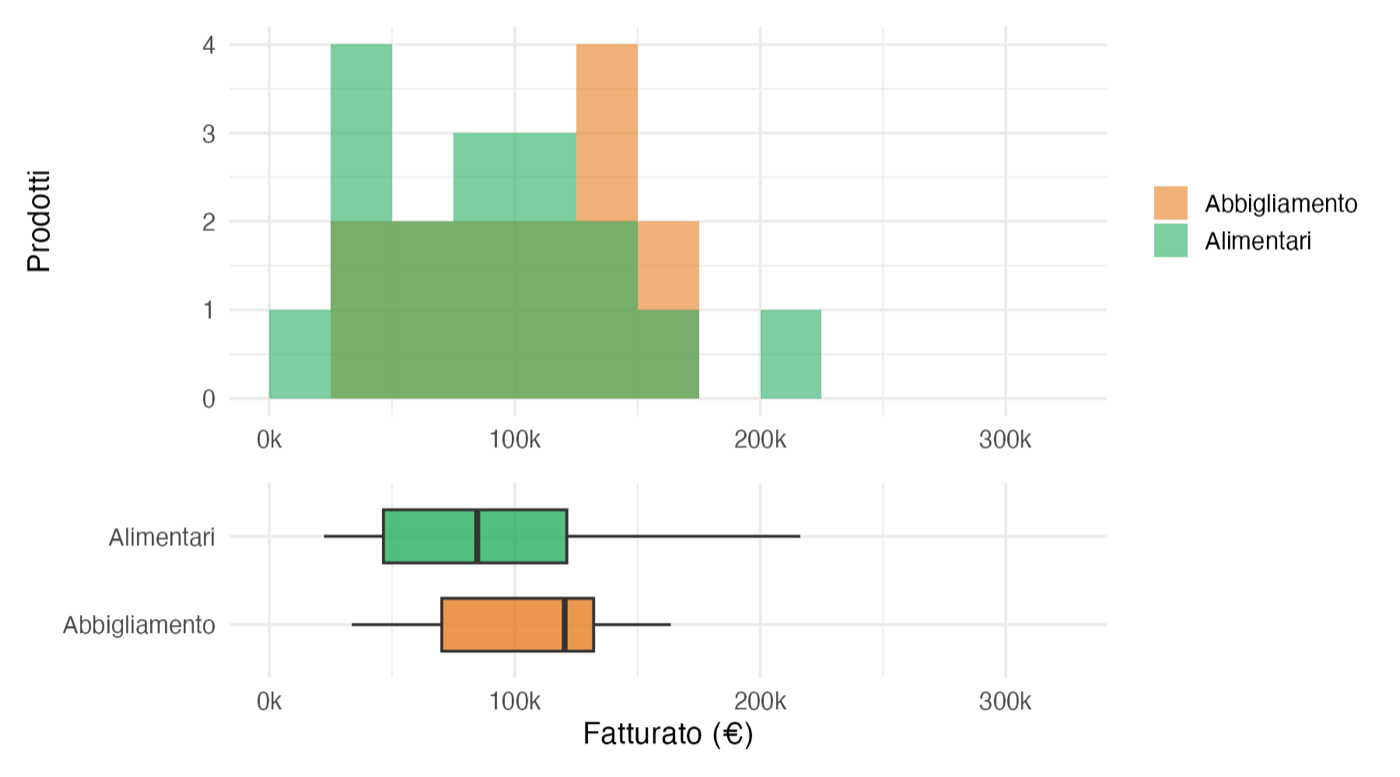
Abbigliamento (SK = −0,59) e Alimentari (SK = 0,77) hanno forme opposte: l’abbigliamento ha molti prodotti in alto e una coda verso il basso, gli alimentari molti prodotti in basso e una coda verso l’alto.
Forma: la curtosi
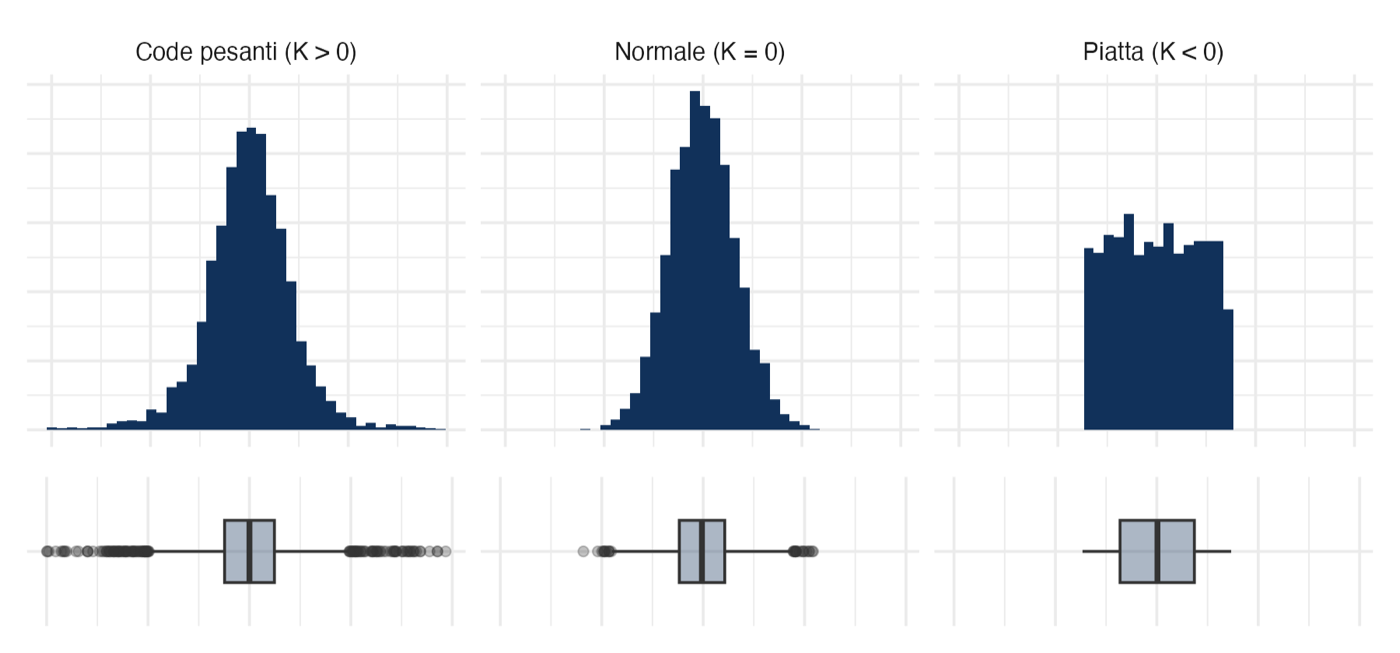
La curtosi dice quanto sono frequenti i valori estremi rispetto a quello che farebbe pensare la deviazione standard:
\[K = \frac{\frac{1}{N}\sum_{i=1}^{N} (x_i - \bar{x})^4}{\left(\frac{1}{N}\sum_{i=1}^{N} (x_i - \bar{x})^2\right)^2} - 3\]- K > 0, code pesanti: i valori estremi capitano più spesso di quanto dica la deviazione standard. Sono i picchi di domanda, i ritardi lunghi, i costi concentrati su pochi prodotti.
- K ≈ 0: media e deviazione standard descrivono bene i dati.
- K < 0, distribuzione piatta: non c’è un valore tipico; i dati sono sparsi o divisi in due gruppi.
La curtosi serve quando la decisione dipende dai casi estremi, non da quello medio. Quattro esempi.
Dove tagliare il costo di magazzino?
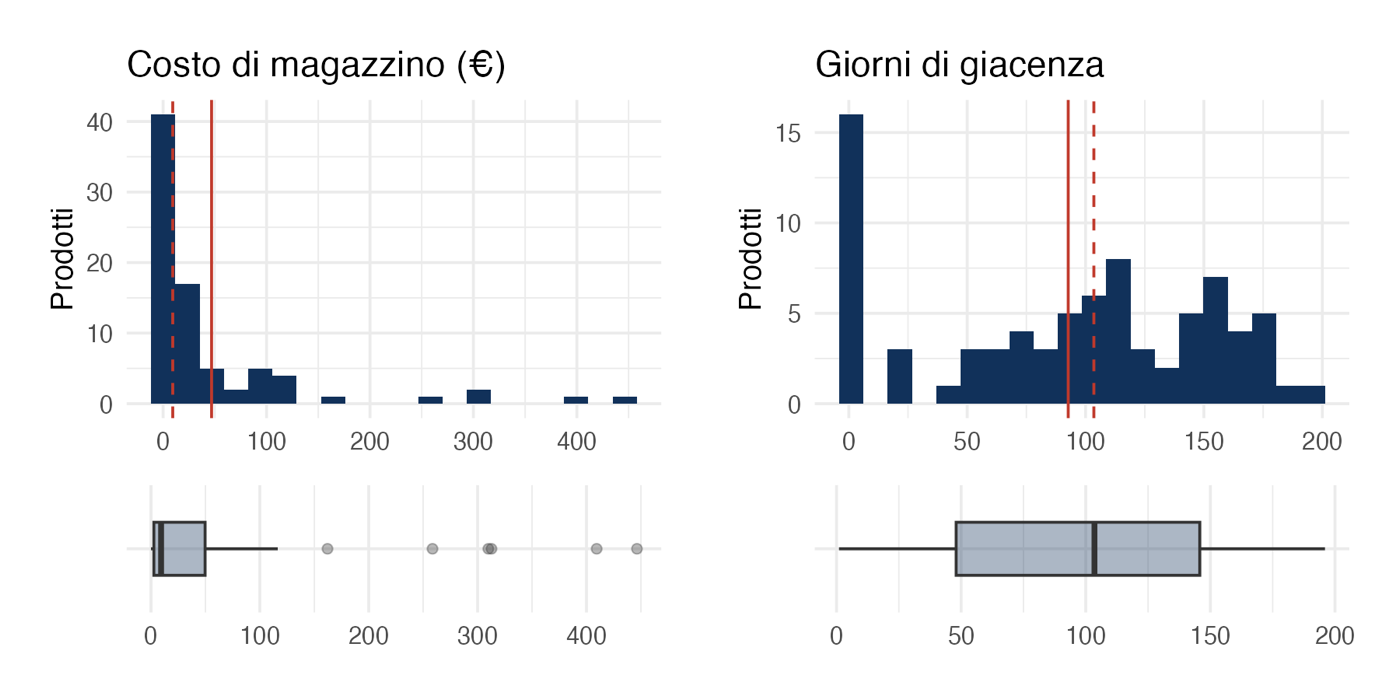
| Media | Mediana | Dev. std. | Skewness | Curtosi | |
|---|---|---|---|---|---|
| Costo di magazzino | 46,84 | 9,30 | 87,95 | 3,01 | 8,79 |
| Giorni di giacenza | 92,67 | 103,50 | 60,56 | −0,27 | −1,16 |
Il costo di magazzino ha code pesantissime: quasi tutti i prodotti costano poco, pochi costano moltissimo. I giorni di giacenza sono il contrario: una distribuzione piatta, dove un prodotto «tipico» non esiste.
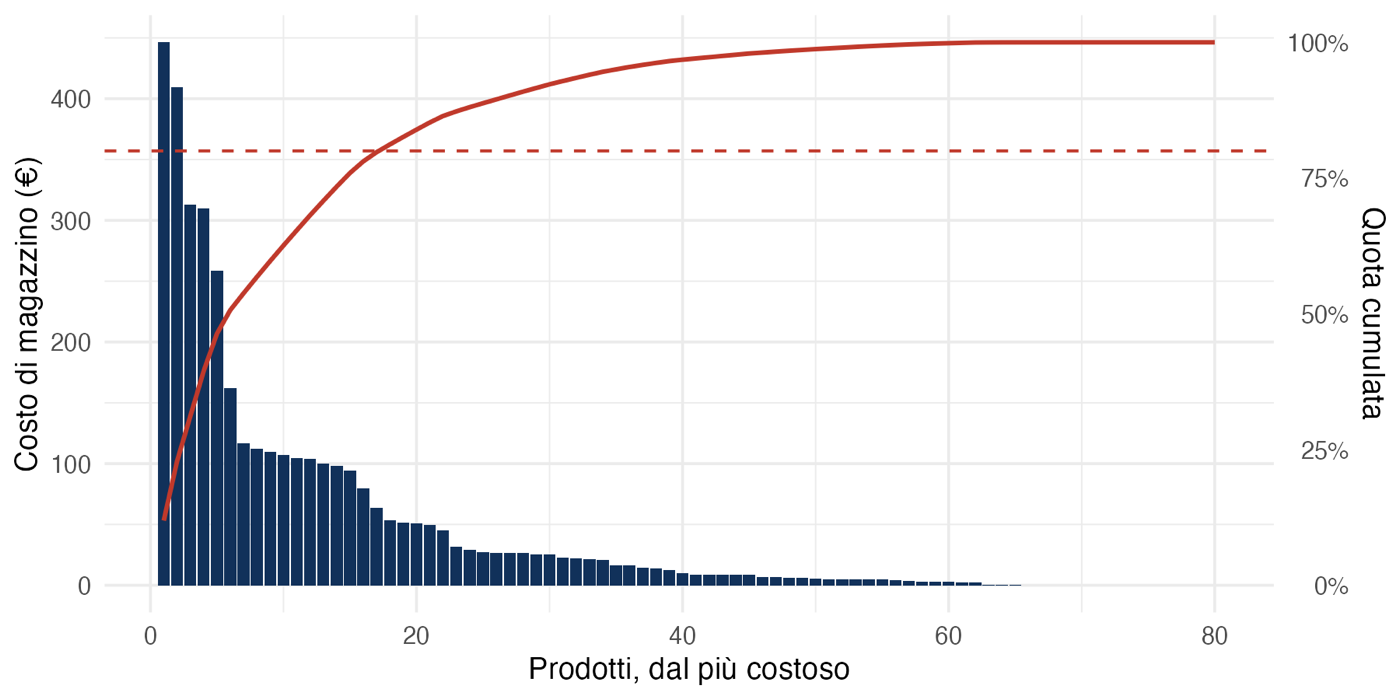
Il grafico di Pareto ordina i prodotti dal più costoso e somma la quota di costo:
\[\text{Quota cumulata}_k = \frac{\sum_{i=1}^{k} c_{(i)}}{\sum_{i=1}^{N} c_i}\]10 prodotti su 80 fanno il 63 % del costo di magazzino, 18 l’80 %. Con una curtosi così alta, ridurre le scorte di tutti un po’ è inutile: si lavora su quei 10.
Quante scorte tenere?
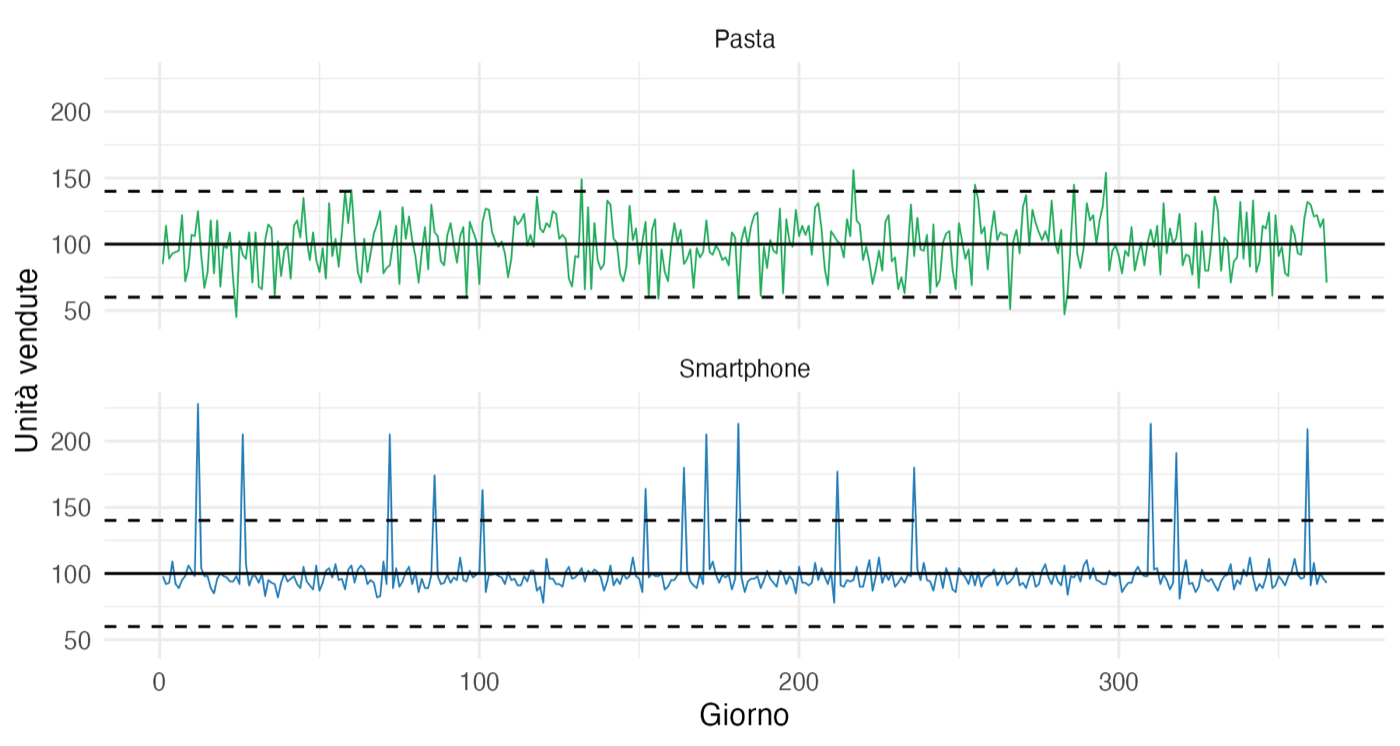
Il file domanda_giornaliera.csv contiene un anno di vendite di due prodotti con la stessa media (100 pezzi al giorno) e la stessa deviazione standard (20). La pasta oscilla tranquilla; lo smartphone di solito resta sotto i 100 (252 giorni su 365), ma nei giorni di promozione esplode. Le linee sono la media e media ± 2 deviazioni standard: \(\bar{x} + 2s = 140\).
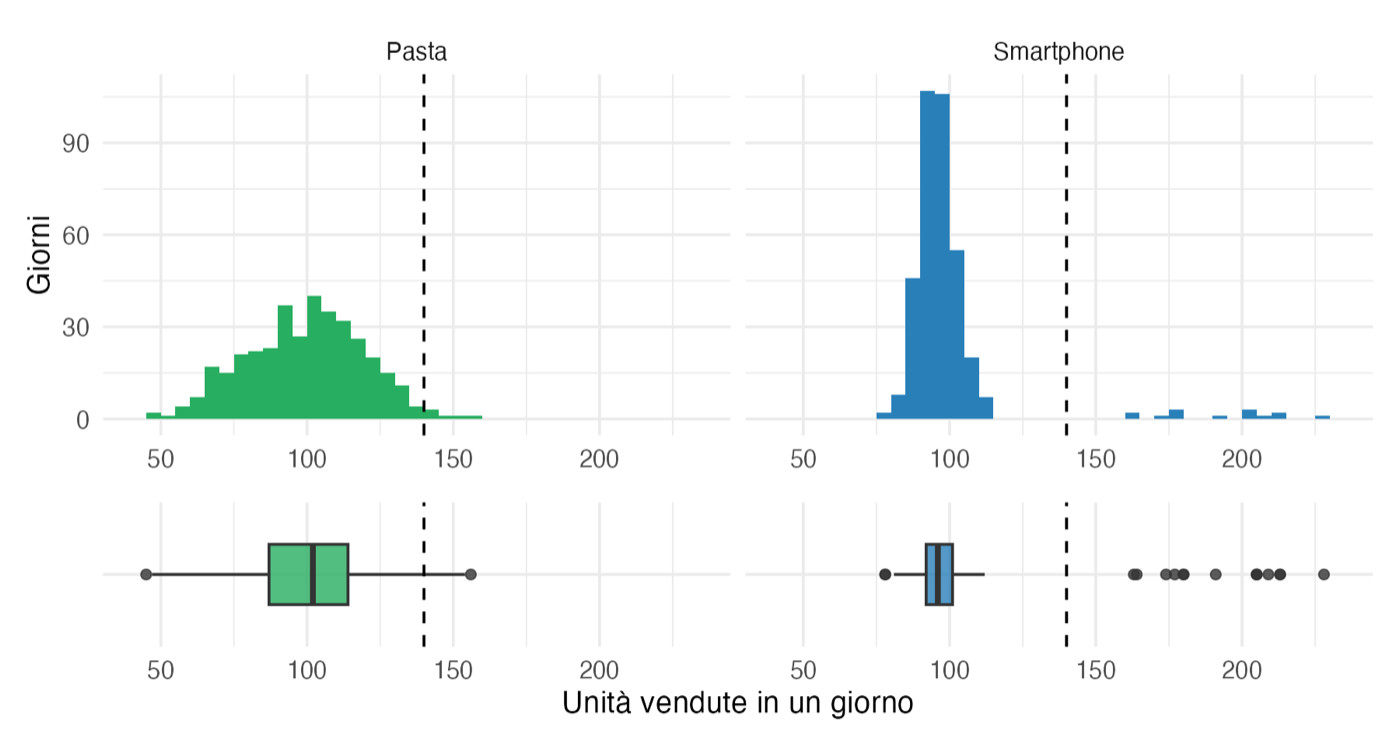
| Media | Dev. std. | Skewness | Curtosi | Giorni oltre 140 | Massimo | |
|---|---|---|---|---|---|---|
| Pasta | 100 | 20 | −0,08 | −0,29 | 6 | 156 |
| Smartphone | 100 | 20 | 4,40 | 20,30 | 14 | 228 |
Chi dimensiona le scorte su media + 2 deviazioni standard tiene 140 pezzi per entrambi. Con la pasta resta senza merce 6 giorni l’anno e di poco; con lo smartphone 14 giorni, e fino a 88 pezzi in meno. Media e deviazione standard sono identiche: la differenza la dice solo la curtosi.
Che tempi di consegna promettere?
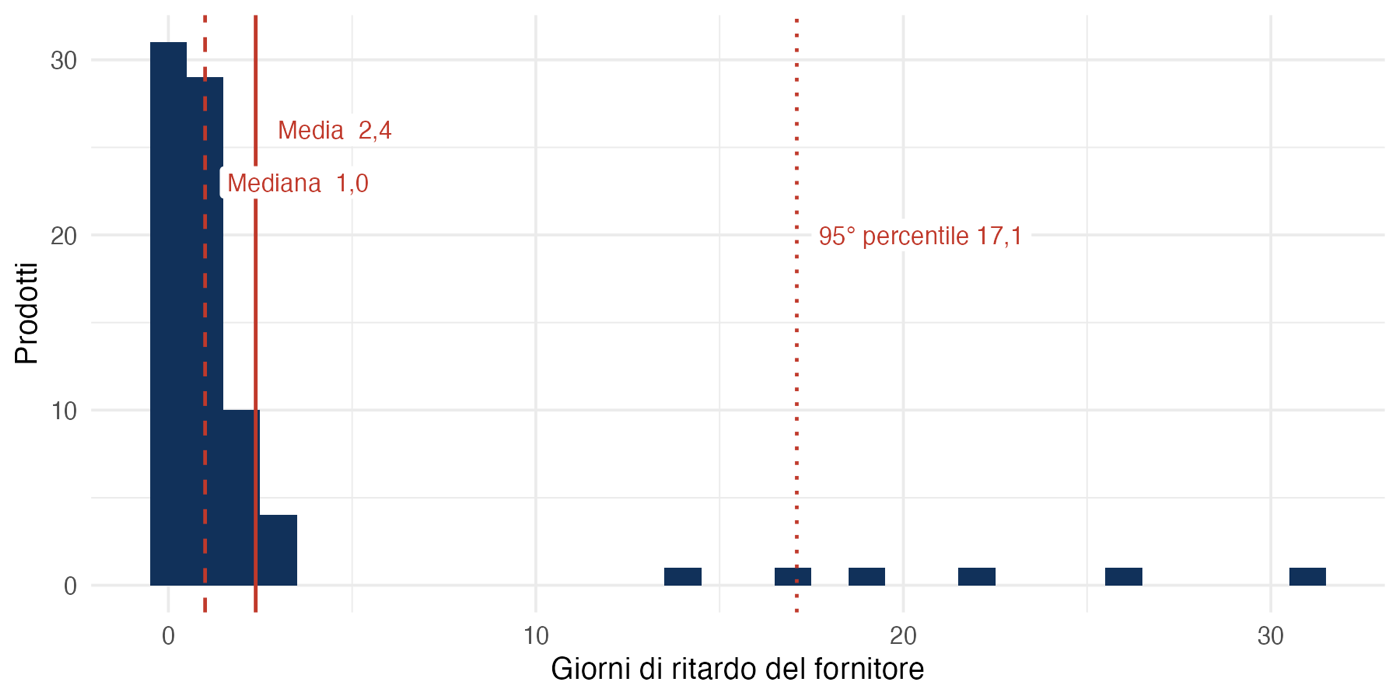
| Media | Mediana | 95° percentile | Skewness | Curtosi |
|---|---|---|---|---|
| 2,4 giorni | 1 giorno | 17,1 giorni | 3,60 | 11,82 |
Per 74 prodotti su 80 il fornitore consegna entro tre giorni, ma sei prodotti arrivano con 14–31 giorni di ritardo. Promettere al cliente «consegna con 2–3 giorni di margine», guardando la media, vuol dire mancare la promessa proprio su quei prodotti. Con una curtosi così alta si promette sul 95° percentile, \(P_{95}\), il valore sotto cui sta il 95 % dei casi.
Il prodotto piace?
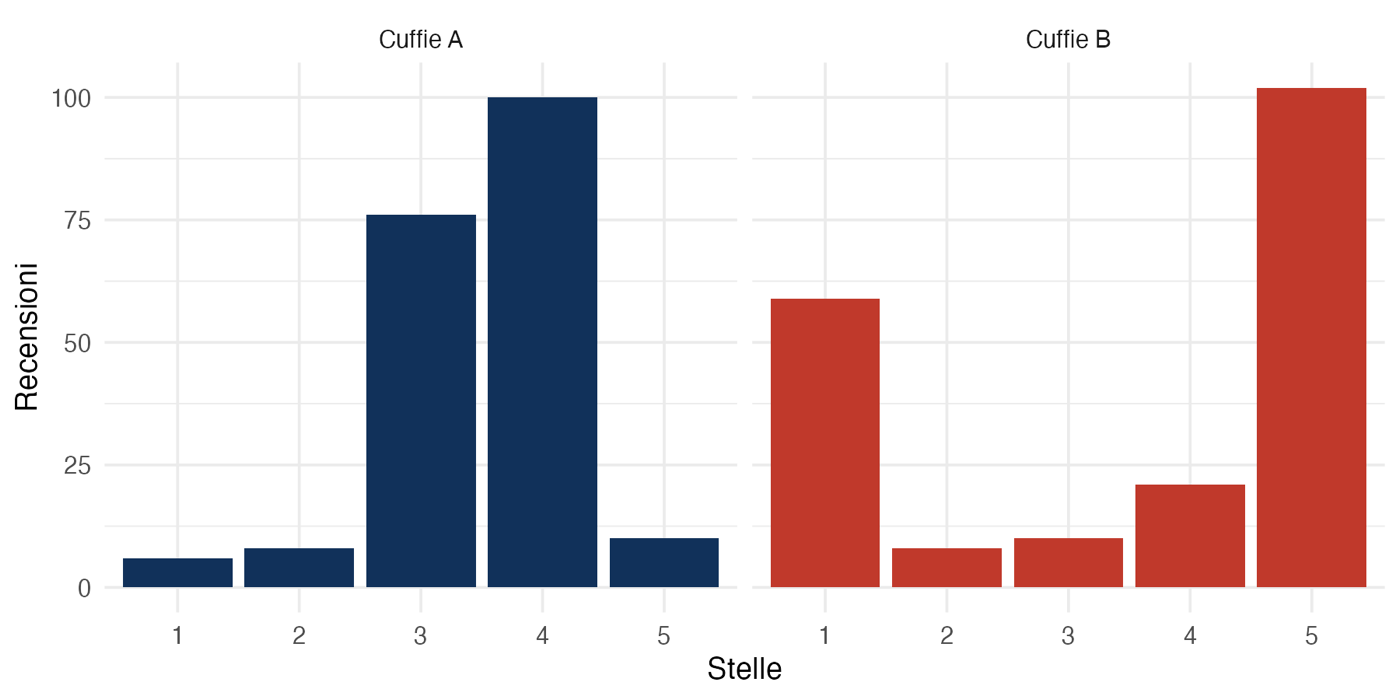
| Cuffie A | Cuffie B | |
|---|---|---|
| Media | 3,50 | 3,50 |
| Dev. std. | 0,78 | 1,77 |
| Curtosi | 1,52 | −1,54 |
| 1 stella | 3 % | 29,5 % |
Due cuffie con la stessa media di 3,5 stelle. Le cuffie A sono concentrate su 3 e 4 stelle (K > 0): un prodotto discreto, senza sorprese. Le cuffie B sono polarizzate (K < 0): metà dei clienti le ama, quasi un terzo le boccia con una stella. Lo dice la curtosi negativa, e il motivo va cercato: un difetto in una parte della produzione, una descrizione che crea aspettative sbagliate.
Due variabili: correlazione
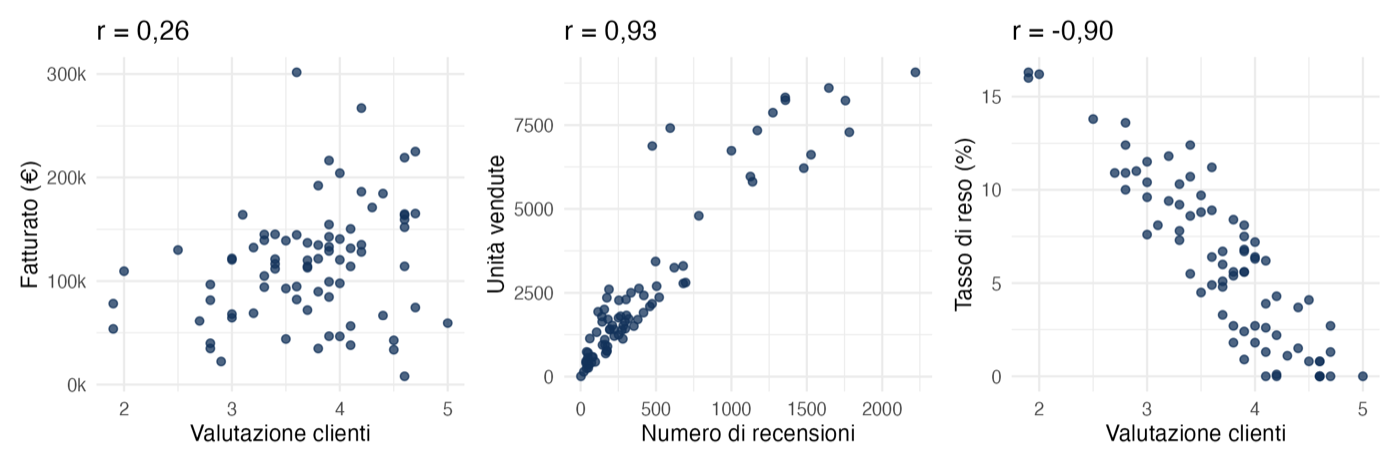
Il grafico di dispersione mette un punto per prodotto. La correlazione va da −1 a 1 e misura quanto due variabili si muovono insieme lungo una retta:
\[Corr(X,Y) = \frac{Cov(X,Y)}{\sqrt{Var(X)\,Var(Y)}} \qquad Cov(X,Y) = \frac{\sum_{i=1}^{N}(x_i - \bar{x})(y_i - \bar{y})}{N-1}\]- valutazione e fatturato, \(r = 0{,}26\): una nuvola quasi senza direzione, i prodotti più apprezzati non sono per forza quelli che fatturano di più;
- recensioni e unità vendute, \(r = 0{,}93\): i punti stanno quasi su una retta che sale, chi vende di più riceve più recensioni;
- valutazione e tasso di reso, \(r = -0{,}90\): una retta che scende, i prodotti meno apprezzati sono quelli che tornano indietro.
Correlazione non è causazione: le recensioni non fanno vendere, ma vendere produce recensioni.
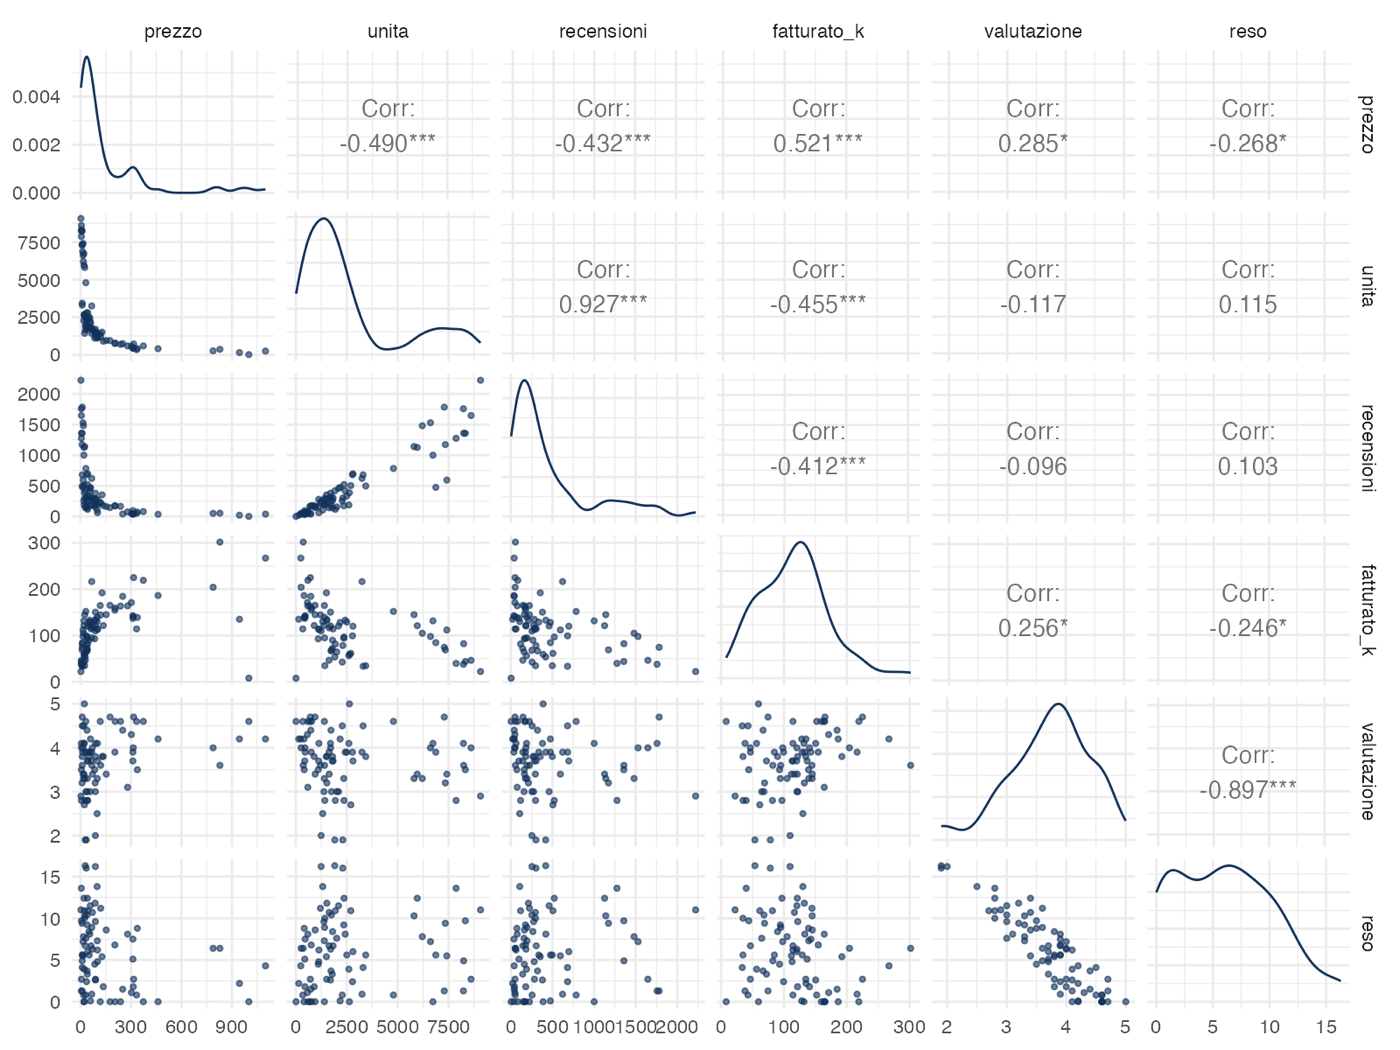
Con più variabili si guardano tutte le coppie insieme: sotto la diagonale i grafici di dispersione, sulla diagonale la distribuzione di ogni variabile, sopra la diagonale la correlazione.
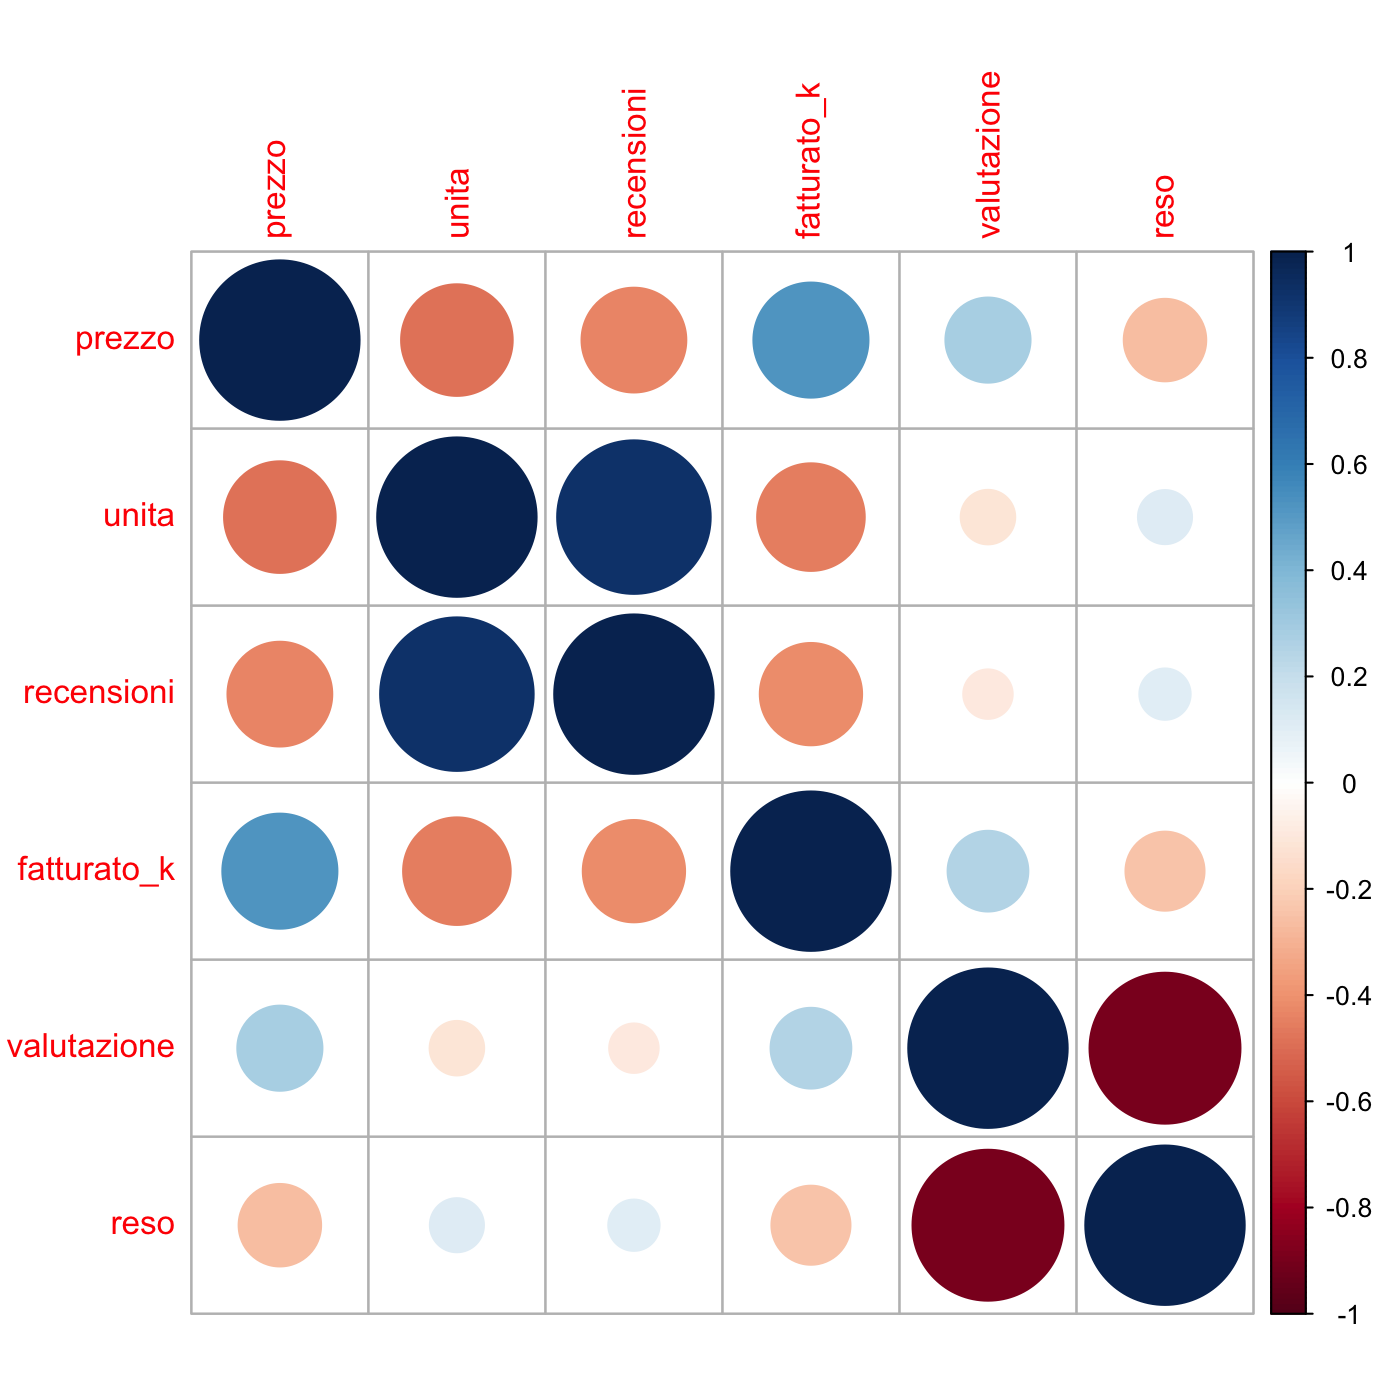
corrplot riassume la stessa matrice a colpo d’occhio: blu per le correlazioni positive, rosso per le negative, cerchi più grandi per quelle più forti. Spiccano le due coppie viste sopra, e il prezzo che sale con il fatturato (0,52) e scende con le unità vendute (−0,49).
cor(vendite$numero_recensioni, vendite$unita_vendute)

numeriche <- vendite %>%
  select(prezzo, unita_vendute, numero_recensioni, fatturato, valutazione_clienti, tasso_reso)
corrplot::corrplot(cor(numeriche))
Per approfondire
I verbi di dplyr usati per preparare ogni grafico sono nel modulo 6. Nel modulo 8 una macchina impara da sola le regole, a partire da tabelle come queste.